
L’ intelligenza artificiale (IA) è un ramo dell’informatica che si occupa della creazione di sistemi capaci di svolgere compiti che normalmente richiederebbero l’ intelligenza umana.
OSSERVATORIO, conoscere l’ I.A.: https://www.ansa.it/sito/static/guida_essenziale_ia.html
Intelligenza Artificiale: significato, storia ed evoluzione di AI Aggiornamento al 29 gennaio 2026
L ’Intelligenza Artificiale è, ormai, una delle più grandi rivoluzioni tecnologiche che l’uomo abbia mai sperimentato: dal Machine Learning, alla Robotica, fino alle Reti neurali. Questi e molti altri ambiti per un’unica grande sfida tecnologica.
L’ Intelligenza Artificiale (abbreviato, a oggi, in IA), infatti, è un tema storicamente e scientificamente ricchissimo e su cui si sono generati diversi dibattiti. Dibattiti che, soprattutto, si sono aperti a seguito del lancio di ChatGPT. L’ Intelligenza Artificiale, dunque, si rifà ad una intima ispirazione dell’ uomo, quella di creare una “macchina” in cui si riflettono appieno le proprie capacità.

Intelligenza Artificiale, che cosa si intende per IA.
Prima di comprendere i meccanismi alla base dell’Intelligenza Artificiale e di spiegare esattamente come funziona l’ IA, bisogna approfondire il concetto di AI. Per farlo, dovremo rispondere in modo chiaro ad un paio di semplici domande:
- Che cosa si intende per Intelligenza Artificiale?
- Qual è l’origine dell’ Intelligenza Artificiale?
Per dare una risposta possiamo, prima di tutto, cercare una definizione puntuale di Intelligenza Artificiale. Quindi, per comprenderne il significato possiamo chiedere aiuto all’Osservatorio Artificial Intelligence del Politecnico di Milano. Ecco come l’ Osservatorio definisce il concetto di IA, rispondendo alla prima delle due domande:
Per quanto si tratti di una tecnologia complessa, l’ idea che sta alla base dell’Intelligenza Artificiale è molto semplice. Si tratta, infatti, di sviluppare delle “macchine” dotate di capacità di apprendimento automatico e di adattamento che siano ispirate ai modelli di apprendimento umani.
Intelligenza Artificiale, le origini: Alan Turing
Dopo aver chiarito e compreso che cosa si intende per Intelligenza Artificiale, possiamo ora chiarire altri due concetti. Il primo concetto da chiarire è perchè si chiama proprio Intelligenza Artificiale, mentre il secondo riguarda le origini dell’IA come disciplina scientifica. Per comprendere la storia dell’Intelligenza Artificiale, tradotto in inglese come Artificial Intelligence, si può chiedere ancora una volta l’aiuto dell’Osservatorio AI del Politecnico. Bisogna aver chiaro che i primi studi in materia di Intelligenza Artificiale le origini e la sua storia come disciplina scientifica, risalgono agli anni Cinquanta. Fu proprio in questo periodo di grande fermento scientifico che si tenne il primo convegno a cui presero parte i maggiori esperti di informatica dell’epoca. Tra questi grandi esperti di informatica c’era anche Alan Turing, considerato uno dei padri dell’informatica moderna. Si può dire, dunque, che chi ha creato l’Intelligenza Artificiale sia proprio Alan Turing. Turing, però, può essere considerato il padre dell’Intelligenza Artificiale solo a livello teorico.
È stato proprio grazie a Turing che l’ Intelligenza Artificiale ai tempi iniziò a ricevere attenzioni da parte della comunità scientifica. Qualche anno prima, all’ interno dell’ articolo “Computing machinery and intelligence”, Alan Turing aveva proposto un test, noto come “Test di Turing”. Secondo questo test, una macchina poteva essere considerata intelligente se il suo comportamento, osservato da un essere umano, fosse stato considerato non distinguibile da quello di una persona.
Campi di applicazione A.I.
L’ intelligenza artificiale (AI) è un campo che ha rivoluzionato numerosi settori, tra cui la sanità, la finanza, il manifatturiero, i trasporti, il marketing, l’ agricoltura e il settore pubblico. L’ AI viene utilizzata per automatizzare i processi, migliorare l’efficienza, personalizzare l’ esperienza dell’ utente e prendere decisioni più informate.
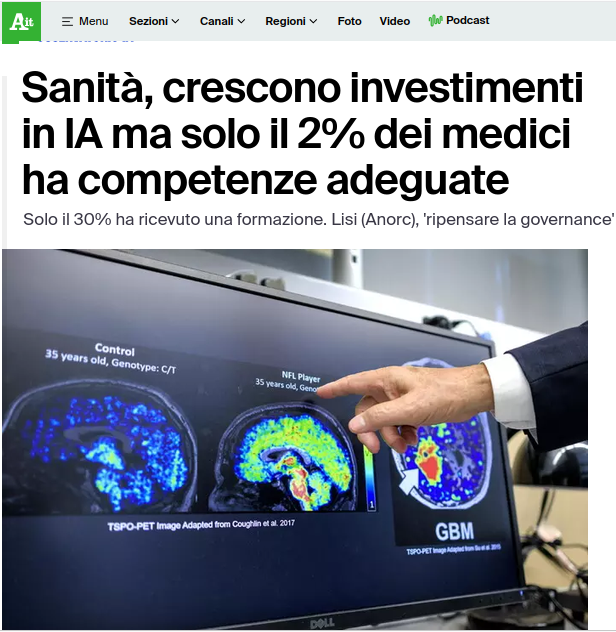
SANITA’: L’ AI viene utilizzata per la diagnosi precoce delle malattie, la prescrizione di farmaci, il monitoraggio dei pazienti e lo sviluppo di nuovi trattamenti.
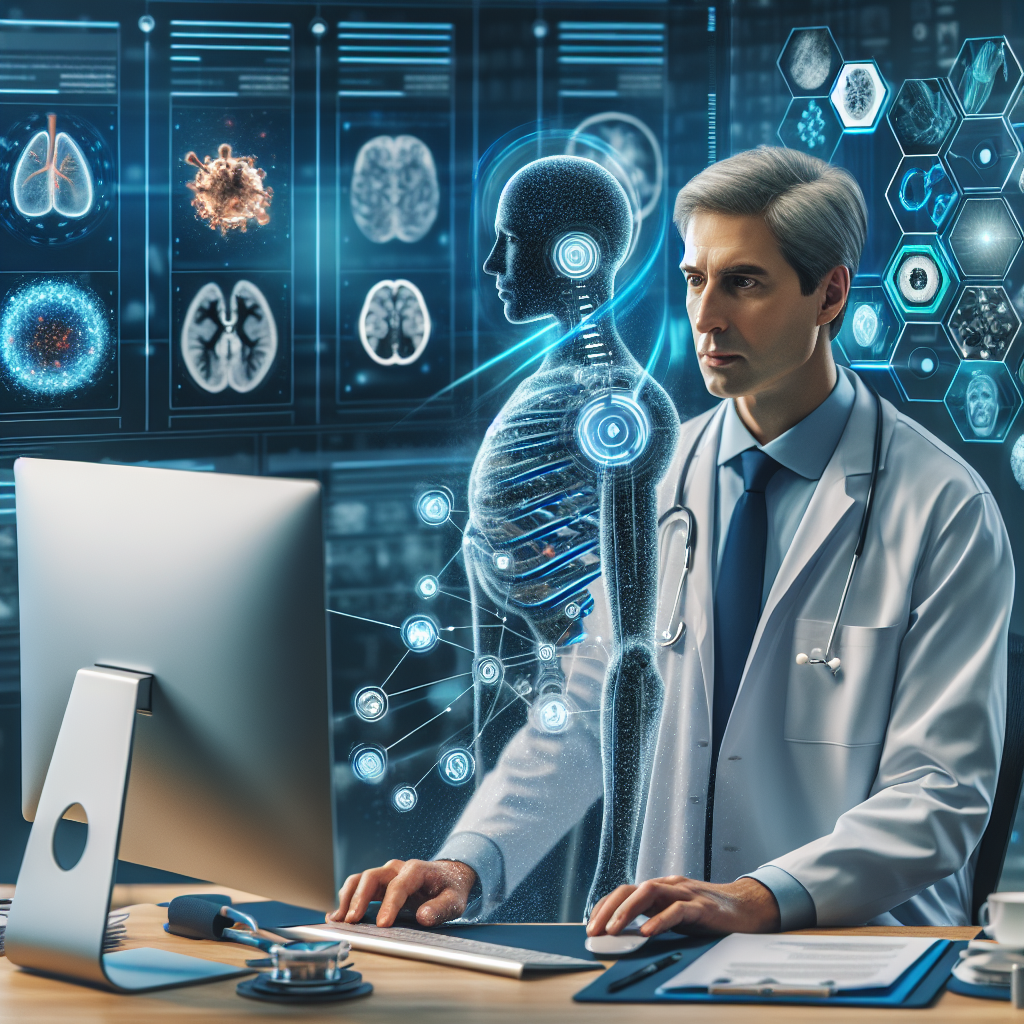
I sistemi di AI possono analizzare le immagini mediche e i dati del paziente per identificare i segni di malattie anche in fase molto precoce.
Quadro normativo e responsabilità in Italia
- Legge 132/2025: In vigore dal 10 ottobre 2025, rappresenta la prima legge italiana organica sull’intelligenza artificiale e recepisce a livello nazionale i principi dell’ AI Act europeo.
- Ruolo del medico e responsabilità: L’ IA fornisce un supporto decisionale, ma la decisione finale resta sempre in capo al medico. Il paziente ha il diritto di essere informato sull’utilizzo di strumenti di IA. In caso di errore diagnostico legato al software, la responsabilità si divide tra la struttura sanitaria (responsabilità contrattuale) e il professionista, valutando il corretto controllo umano e il tipo di prestazione.
MANIFATTURIERO: L’ AI viene utilizzata per automatizzare i processi di produzione, ottimizzare la catena di approvvigionamento e migliorare la manutenzione predittiva dei macchinari.
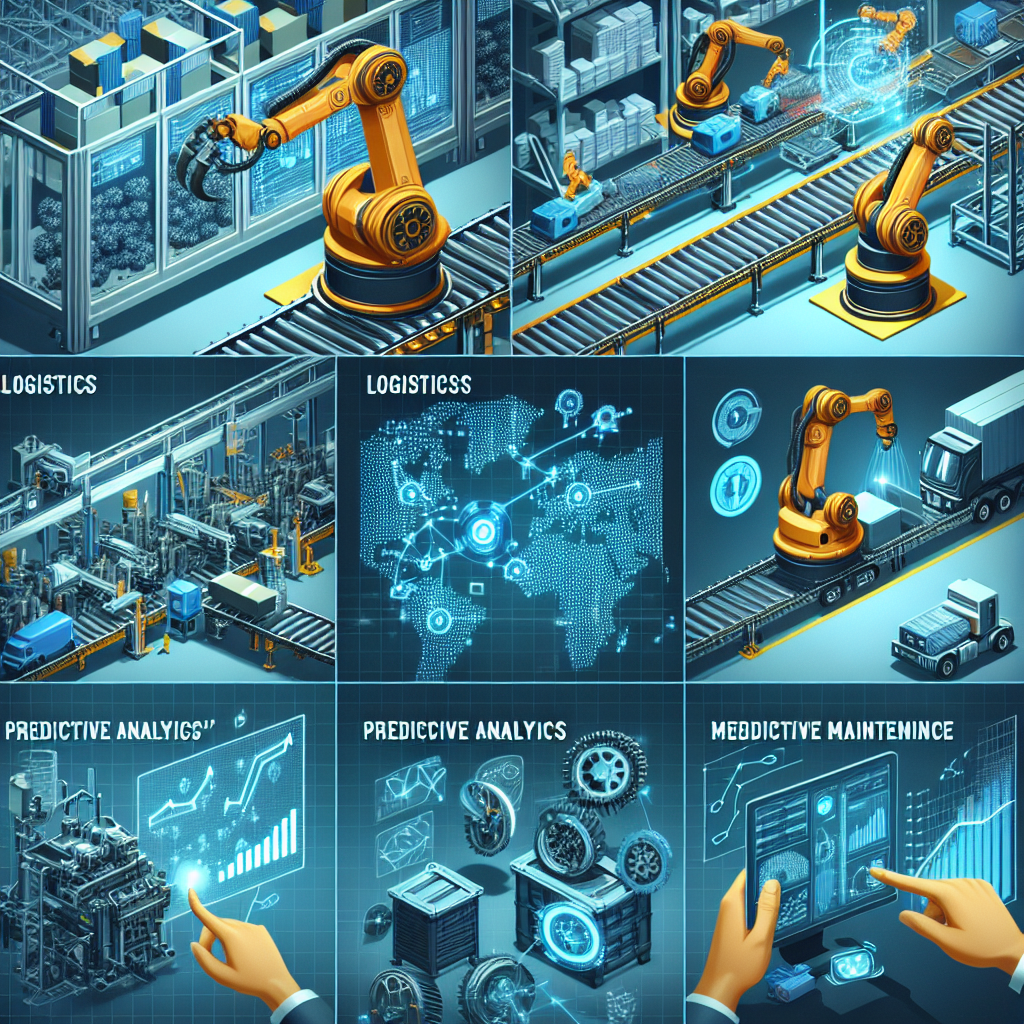
L’ IA può essere utilizzata per automatizzare attività come il controllo qualità, la manutenzione predittiva e la gestione dell’ inventario, liberando i dipendenti per concentrarsi su attività più strategiche.
Dall’ IA sensori indossabili e robot collaborativi “Cobot” per la sicurezza sul lavoro.
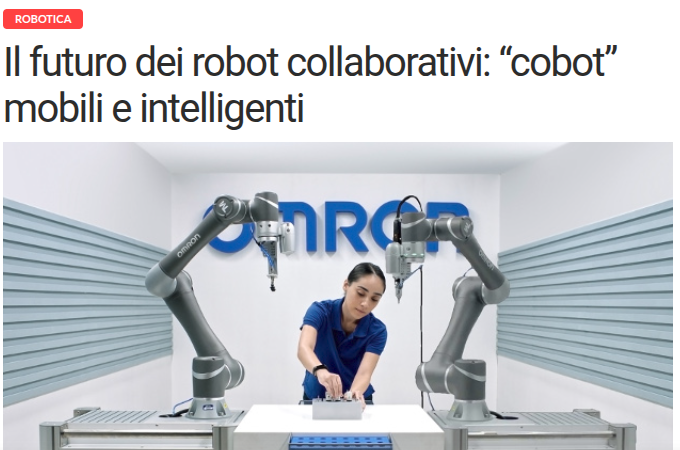
Cosa sono i “Cobot”?
I cobot (abbreviazione di collaborative robot, ossia robot collaborativi) sono bracci o sistemi robotici progettati per lavorare fianco a fianco con gli esseri umani nello stesso spazio di lavoro, senza bisogno delle tradizionali gabbie o barriere fisiche di protezione. A differenza dei robot industriali classici (che sono completamente autonomi, veloci e isolati per motivi di sicurezza), i cobot sono pensati per assistere l’operatore umano in compiti ripetitivi, faticosi o di precisione.
Caratteristiche principali:
Sicurezza intrinseca: Sono dotati di sensori di coppia su ogni giunto e sistemi di monitoraggio di velocità e forza. Se rilevano un contatto anomalo o una collisione con un operatore, si bloccano immediatamente. Nessuna barriera: Possono operare liberamente accanto alle persone grazie a normative e standard di sicurezza dedicati. Facilità di programmazione: Molti modelli si programmano “a mano” (guidando il braccio del robot a fare il movimento) oppure tramite interfacce software intuitive. Flessibilità: Possono essere spostati facilmente da una postazione all’altra della catena produttiva. Differenza dai robot autonomi: I cobot non sostituiscono l’uomo o lavorano in totale autonomia senza supervisione in ambienti chiusi; nascono per la cooperazione (interazione diretta uomo-macchina).
AGRICOLTURA: L’ AI viene utilizzata per la gestione delle colture, il monitoraggio delle piante, la previsione delle condizioni climatiche e la ottimizzazione della produzione alimentare.

L’ intelligenza artificiale (IA) sta rivoluzionando l’ agricoltura, migliorando la produttività, l’ efficienza e la sostenibilità. L’ IA si applica in diverse fasi, dall’ identificazione delle malattie delle piante alla gestione dell’irrigazione, ottimizzando l’ uso delle risorse e riducendo i costi.
AMMINISTRAZIONE PUBBLICA: Costruire una P.A. più moderna ed efficiente

La “P.A. Aumentata” utilizza l’Intelligenza Artificiale come amplificatore delle competenze umane, creando una sinergia tra uomo e macchina. Questo approccio mira a migliorare l’ efficienza e la qualità dei servizi pubblici, richiedendo però un cambiamento culturale, investimenti in formazione e semplificazione burocratica per una trasformazione efficace.
A.I. per la P. A., tutte le applicazioni per migliorare i servizi ai cittadini:
Nel capitolo 5 del nuovo Piano triennale Ict c’è una parte dedicata all’ utilizzo dell’intelligenza artificiale nella pubblica amministrazione. In attesa che vengano rese disponibili le Linee Guida da parte di AGID sui passi metodologici e organizzativi che le pubbliche amministrazioni devono seguire per definire attività progettuali di innovazione mediante l’ utilizzo di IA, è già possibile fin da ora dare qualche esempio di applicazioni pratiche, che possono dare indicazioni utili per iniziare a sviluppare qualche idea progettuale.
Indice degli argomenti collegati ed applicabili nella P.A.:
- AI per la Pa, le indicazioni del Piano triennale Ict
- Impatto dell’IA sul lavoro e sui cittadini
- La situazione nella pubblica amministrazione
- Documentale semantico per la Pubblica amministrazione
- Intelligenza artificiale per la redazione e semplificazione normativa
- Il caso della Regione Emilia-Romagna
- Gestione delle PEC in arrivo
- Graduatorie dei concorsi pubblici
- Recupero dell’evasione fiscale
- Cybersecurity
- Verifica dei documenti digitali
- Chat Bot per l’assistenza ai clienti
- Obiettivi e considerazioni finali
Uso dell’ intelligenza artificiale nei sistemi giudiziari:

L’intelligenza artificiale (IA) offre nuove opportunità e sfide per il sistema di giustizia. Da un lato, l’IA può migliorare l’ efficienza, la precisione e la prevedibilità delle decisioni giudiziarie, aiutando nella gestione dei processi e nell’ analisi dei dati. Dall’altro, l’uso dell’ IA solleva importanti questioni etiche e legali, riguardanti la trasparenza, la responsabilità e il rischio di bias* nelle decisioni algoritmiche. *Cosa si intende per bias?: (Il bias è una forma di distorsione della valutazione causata dal pregiudizio). La mappa mentale di una persona presenta bias laddove è condizionata da concetti preesistenti non necessariamente connessi tra loro da legami logici e validi.
Draghi lancia l’allarme sull’ AI: «L’ Europa deve costruire più data center o rischia di restare senza potenza di calcolo» 11/09/2026
L’ UE ospita meno del 5% della capacità mondiale di calcolo per l’intelligenza artificiale, contro il 75% degli Stati Uniti. Per l’ex premier servono investimenti nelle infrastrutture e un nuovo modello per aggregare la domanda delle aziende europee.
Google lancia Gemini 2.0, l’ ‘I.A. assistente universale del futuro’:
Google ha recentemente introdotto Gemini 2.0, descritto come “l’assistente universale del futuro”. Questo avanzato sistema di intelligenza artificiale è stato progettato per integrare una vasta gamma di funzionalità, rendendolo un compagno essenziale per utenti di ogni tipo. Gemini 2.0 promette di offrire un’interazione utente ancora più intuitiva e personalizzata, grazie a miglioramenti nel riconoscimento del linguaggio naturale e nella capacità di apprendimento automatico. Con la sua capacità di adattarsi alle esigenze specifiche degli utenti, Gemini 2.0 rappresenta un passo significativo verso una maggiore integrazione dell’ IA nella vita quotidiana.
Novembre 2025: L’ecosistema Gemini si è ampliato per includere strumenti più potenti, maggiore integrazione multimodale, funzionalità audio native e agenti intelligenti capaci di operare in autonomia. Con Gemini 2.5, Google ridefinisce lo standard qualitativo dell’intelligenza artificiale generativa. Le novità introdotte non solo migliorano le performance e la qualità delle risposte, ma abilitano anche nuove modalità di interazione tra uomo e macchina, in particolare grazie al supporto vocale, alla generazione video e agli agenti automatizzati. L’approccio scalabile, con piani accessibili a diversi tipi di utenti, rende Gemini una piattaforma versatile, utile sia in ambito educativo e personale, sia in contesti aziendali avanzati. Nei prossimi mesi, l’espansione dei piani Ultra e l’integrazione progressiva delle funzionalità come Deep Think e Project Mariner potrebbero consolidare ulteriormente il primato di Google nell’ecosistema AI globale. Un’opportunità concreta per innovare il modo in cui cerchiamo, lavoriamo, comunichiamo e creiamo contenuti digitali. Gemini non è solo una tecnologia, ma un’infrastruttura adattiva pensata per evolvere con le esigenze della società digitale contemporanea.
Gemini 3.0 di Google
Gemini 3.0 è il nostro modello Gemini di ragionamento più avanzato, in grado di risolvere problemi complessi. Gemini 2.5 Pro può comprendere vasti set di dati e problemi complessi provenienti da diverse fonti di informazione, tra cui testo, audio, immagini, video e persino interi repository di codice.
Gemini 2.5 Pro è una versione sperimentale dei nuovi modelli AI di Google. Si tratta di una soluzione in grado di sviluppare ed elaborare dei pensieri complessi prima di fornire delle risposte, il che migliora la qualità e la precisione dei risultati forniti all’ utente.
Gemini è una famiglia di modelli di intelligenza artificiale sviluppata da Google, che include modelli linguistici di grandi dimensioni (LLM-Large Language Model) e modelli multimodali capaci di elaborare testo, immagini, audio e codice. È il successore di Bard ed è integrato in molti prodotti Google, come Gmail, Google Docs, Google Maps e la nuova Google Search. Gemini è progettato per assistere gli utenti in varie attività, dalla scrittura e pianificazione alla ricerca e all’apprendimento, e per migliorare l’interazione con i servizi Google. In breve, Gemini è un potente strumento di intelligenza artificiale che offre un’ampia gamma di funzionalità per assistere gli utenti in diversi ambiti, dalla scrittura e la ricerca alla pianificazione e all’apprendimento, integrandosi in modo efficace con i prodotti e i servizi Google che già utilizziamo quotidianamente. Gemini 2.5 Pro è una versione sperimentale dei nuovi modelli AI di Google. Si tratta di una soluzione in grado di sviluppare ed elaborare dei pensieri complessi prima di fornire delle risposte, il che migliora la qualità e la precisione dei risultati forniti all’utente.
Cosa sono gli LLM?
Gli LLM, o Large Language Model, sono modelli di intelligenza artificiale addestrati su enormi quantità di dati testuali per comprendere e generare linguaggio umano
Sono in grado di svolgere una varietà di compiti, come rispondere a domande, tradurre testi, riassumere contenuti e scrivere testi originali. Esempi comuni includono il GPT di OpenAI, Gemini di Google e Copilot di Microsoft.
Come funzionano
- Addestramento: Vengono addestrati su vaste raccolte di testi provenienti da libri, articoli e dal web, da cui “Large” (grande) deriva il loro nome.
- Reti neurali: Utilizzano architetture di reti neurali, in particolare i Transformer, per analizzare il linguaggio e identificare schemi, strutture e significati.
- Previsione: Imparano a prevedere la parola successiva in una sequenza, permettendo loro di generare testo che appare coerente e pertinente.
Capacità principali
- Comprensione: Capiscono la grammatica, il significato e l’intento del linguaggio naturale.
- Generazione: Possono scrivere saggi, storie e articoli di blog, imitando persino lo stile di scrittura di un autore specifico.
- Traduzione: Eseguono traduzioni tra lingue diverse.
- Riassunto: Possono estrarre le informazioni chiave da documenti e creare riassunti concisi.
- Analisi del sentiment: Analizzano il tono di un testo per determinare se è positivo, negativo o neutro.
- Generazione di codice: Assistono gli sviluppatori nella creazione e nel debug del codice.
Esempi e applicazioni
- Chatbot: Forniscono risposte conversazionali e assistenza.
- Assistenza sanitaria: Possono analizzare report medici per individuare possibili patologie.
- Servizio clienti: Automatizzano le interazioni con i clienti.
- Finanza: Aiutano ad automatizzare le transazioni finanziarie e l’elaborazione dei dati.
Gemini 2.5, tutte le nuove funzionalità AI di Google:
Le ultime novità di Gemini 2.5:
- Gemini 2.5 Flash,
- Gemini 2.5 Pro,
- Modalità Deep Think,
- Audio nativo e sintesi vocale avanzata,
- Project Mariner,
- Integrazione multimodale avanzata.
Indice degli argomenti:
- Gemini 2.5 Flash: Il Flash rappresenta una versione ottimizzata per velocità ed efficienza. È stato progettato per ridurre sensibilmente il consumo di token (dal 20% al 30% in meno rispetto alla versione precedente), garantendo al contempo elevate prestazioni nella generazione di testo, codice e contenuti multimodali. È ideale per interazioni rapide e meno complesse, mantenendo comunque un buon livello di qualità. La sua leggerezza lo rende adatto a contesti mobile-first o applicazioni a basso costo computazionale. Esempio Pratico: immagina un’app di notizie sul tuo smartphone. Con Gemini 2.5 Flash, potresti chiedere un riassunto immediato di un articolo lungo mentre sei in movimento, oppure potresti usare un chatbot di assistenza clienti integrato in un’app di e-commerce per ottenere risposte fulminee a domande frequenti come “Quali sono i tempi di spedizione?”.
- Gemini 2.5 Pro: Il Pro è il modello di punta della serie, è pensato per affrontare compiti più complessi e articolati. Supporta un contesto fino a 1 milione di token, utile per l’elaborazione di lunghi documenti o conversazioni articolate. Include capacità potenziate di ragionamento logico, risoluzione di problemi tecnici, e comprensione multimodale tra testi, immagini, audio e video. È particolarmente indicato per la ricerca accademica, lo sviluppo software, l’elaborazione di documenti legali e la consulenza aziendale automatizzata. Esempio Pratico: un team legale potrebbe caricare un intero corpus di leggi e normative relative a un caso specifico. Successivamente, potrebbe chiedere a Gemini 2.5 Pro di analizzare un contratto di centinaia di pagine per identificare clausole rilevanti, potenziali rischi o per confrontarlo con la giurisprudenza esistente, ricevendo un’analisi dettagliata e contestualizzata. Oppure, uno sviluppatore software potrebbe fornire a Gemini Pro una base di codice complessa e chiedere di identificare bug, suggerire ottimizzazioni o persino generare documentazione tecnica.
- Modalità Deep Think: Una delle innovazioni più attese, è la modalità Deep Think, pensata per permettere al modello di eseguire catene di ragionamento più lunghe e sofisticate. Attualmente in fase di test presso utenti selezionati, potrebbe rivoluzionare la capacità degli LLM di affrontare scenari complessi come problemi matematici avanzati o argomentazioni logiche articolate. Deep Think è anche studiata per essere particolarmente efficace in ambienti educativi e nella risoluzione assistita di esercizi STEM. Esempio Pratico: uno studente di dottorato che lavora su una tesi complessa potrebbe utilizzare Deep Think per esplorare diverse linee di argomentazione, analizzare dati sperimentali e ricevere assistenza nella formulazione di ipotesi e nella stesura di passaggi logici complessi, quasi come se stesse facendo brainstorming con un esperto del dominio.
- Audio nativo e sintesi vocale avanzata: Gemini ora include un modulo TTS (text-to-speech) integrato che consente al modello di rispondere con una voce naturale, capace di esprimere emozioni e sfumature tonali. Questo lo rende particolarmente adatto per l’uso in contesti vocali, come assistenti digitali o applicazioni educative interattive. La varietà di stili vocali personalizzabili lo rende anche interessante per contenuti multimediali e podcast automatizzati. Esempio Pratico: un’applicazione per l’apprendimento delle lingue potrebbe usare Gemini per creare dialoghi realistici. Se l’utente fa un errore, la voce di Gemini potrebbe rispondere con un tono incoraggiante e fornire la correzione. Per i creatori di contenuti, si potrebbero generare podcast con voci diverse per gli speaker o narrazioni di audiolibri con un’espressività che cattura l’attenzione dell’ascoltatore.
- Project Mariner: Un agente AI in grado di eseguire comandi complessi all’interno di interfacce browser. Mariner introduce una componente agentica autonoma che consente di navigare, cliccare, riempire form e interagire con pagine web secondo logiche definite. Questa tecnologia apre nuove prospettive per la produttività automatizzata, il customer support intelligente e la generazione autonoma di report dinamici. Esempio Pratico: un piccolo imprenditore potrebbe chiedere a Project Mariner: “Ogni lunedì mattina, accedi al mio account di web analytics, estrai i dati di traffico delle ultime due settimane, confrontali con il periodo precedente, identifica le prime 3 fonti di traffico in crescita e inviami un riepilogo via email con un grafico”. Project Mariner eseguirebbe autonomamente questi passaggi.
- Integrazione multimodale avanzata: Gemini supporta pienamente input e output multimodali. Ciò include testo, codice, immagini generate con Imagen 4, video creati tramite Veo 3, audio e input vocali. Questa versatilità lo rende un modello applicabile a un’ampia gamma di casi d’uso, dalla produzione creativa all’automazione industriale. Inoltre, la possibilità di combinare più modalità in un’unica interazione consente esperienze utente sempre più fluide e contestualizzate. Esempio Pratico: un architetto potrebbe caricare una foto di uno spazio esistente (immagine), descrivere a voce le modifiche desiderate (audio) e chiedere a Gemini di generare diverse proposte di design in formato immagine (con Imagen 4) e un breve video walkthrough (con Veo 3) per ogni proposta, accompagnato da una descrizione testuale dei materiali e dei costi stimati.
8 Agosto 2025, ore 12:00: ChatGPT ha un nuovo modello, OpenAI presenta GPT-5:
Gpt-5, come cambia da subito ChatGpt con il nuovo modello
OpenAI ha lanciato GPT-5, disponibile già da oggi per tutti. Rispetto al modello precedente, è più veloce, preciso e capace di ragionare in modo avanzato senza ricorrere a impostazioni manuali.
Chi può usare ChatGPT con GPT-5
Per quanto riguarda la disponibilità di GPT-5, l’accesso al nuovo modello è già garantito a tutti gli utenti ChatGPT, con differenze solo nei limiti di utilizzo: gli abbonati Pro e Plus possono impiegarlo praticamente senza restrizioni, mentre chi usa la versione gratuita avrà a disposizione un certo numero di interazioni complete prima di passare automaticamente alla versione mini. OpenAI non ha specificato su quante interazioni possono contare gli utenti free prima di passare a GPT-5 mini.
Google ha lanciato Gemini 3 il 18 novembre 2025
Google lancia Gemini 3, il suo modello AI più avanzato, colmando il divario con ChatGPT. Un significativo salto di qualità nell’intelligenza artificiale, concentrandosi sul ragionamento multimodale avanzato (vedendo immagini e video nativamente, non convertendoli), capacità potenziate per la programmazione e l’azione come agente AI, con versioni come Gemini 3 Pro (disponibile) e Gemini 3 Deep Think (per utenti Ultra), e l’efficace Gemini 3 Flash per compiti veloci. Questo modello gestisce contesti lunghi (fino a 1 milione di token), eccelle nei benchmark e si propone come un vero partner per creare, imparare e pianificare, integrandosi in vari prodotti Google.
Caratteristiche principali
- Ragionamento Multimodale Nativo: Vede e comprende immagini, video, audio e testo simultaneamente senza bisogno di traduzioni intermedie, riducendo latenza ed errori.
- Capacità Agentiche Potenziate: Grazie a piattaforme come Google Anti Gravity, può agire come agente operativo per compiti complessi come prenotazioni o gestione email.
- Eccellenza nella Programmazione: È il modello più potente per il coding, migliorando significativamente le performance e l’integrazione.
- Gestione di Contesti Lunghi: Affronta prompt complessi con fino a 1 milione di token, unendo documenti, codice, immagini e video.
- Efficienza e Velocità: Gemini 3 Flash è ottimizzato per velocità e minor consumo di risorse, adattando il ragionamento al compito.
Versioni principali
- Gemini 3 Pro: La versione iniziale, con ragionamento avanzato e capacità multimodali, integrata nei prodotti Google.
- Gemini 3 Flash: Veloce ed efficiente, ideale per attività quotidiane e analisi di immagini.
- Gemini 3 Deep Think: La modalità di ragionamento più avanzata, per prestazioni estreme, in fase di test di sicurezza.
Cosa può fare
- Analizzare video e immagini complesse.
- Generare contenuti di alta qualità (testi, immagini, codice).
- Fungere da partner di pensiero, offrendo risposte più dirette.
- Gestire flussi di lavoro multi-step e compiti operativi.
In sintesi, Gemini 3 segna un’era di intelligenza artificiale più potente e integrata, superando i benchmark precedenti e offrendo funzionalità avanzate per utenti e sviluppatori.